Kai 2025-ųjų sausio 27-tą dieną kinų įmonės DeepSeek aplikacija užėmė pirmą vietą Apple JAV AppStore, dirbtinio intelekto ekosistemą sukrėtė netikėtas šokas. R1 modelis buvo ypatingas tuo, kad pajėgumu lyginosi su geriausiais OpenAI ChatGPT modeliais, už dalelę kainos. O svarbiausia, tai buvo “atviras” modelis – bet kas galėjo parsisiųsti jo kopiją ir naudoti, kiek širdis geidžia, be jokių tarpininkų.
Nvidia akcijos kaina tą dieną smuko žemyn 16,4%. Rodės, JAV kuruojamas dirbtinio intelekto verslo modelis sugrius – jei galima tas pačias užduotis atlikti naudojant keliasdešimt kartų pigiau, t.y. naudojant tiek pat kartų mažiau resursų, akivaizdu, kad reikės keliasdešimt kartų mažiau infrastruktūros, duomenų centrų, grafinių lustų, ir t.t. O OpenAI rodės, jau tikrai tuoj kojas užvers.
Bet šios prognozės taip ir nepasiteisino. OpenAI išleido naujus, galingesnius modelius, prisistatė ir Anthropic su savo Claude, ir Google su savo Gemini, ir rinka nusprendė, kad bus vietos visiems – ir brangiems, vadinamiems “frontier” modeliams, ir pigiems “open source” modeliams.
Ką reiškia “brangus” ar “pigus” modelis? Modelio kaina skaičiuojama, kiek kainuoja žodžiai (“tokens”) – tiek įvedant užduotį (“input tokens”), tiek išgaunant rezultatą (“output tokens”). Įvesti daug žodžių svarbu, kad dirbtinis intelektas pagautų kontekstą, na o gauti daugiau nei keletą žodžių rezultate irgi neblogai.
Šiandien modeliai kainuoja nuo 2 centų už milijoną “input tokens” ir 10 centų už milijoną “output tokens”, iki 5 dolerių ir 25 dolerių už milijoną “input/output tokens”.
Dar rinka nusprendė, kad dirbtiniui intelektui pasitarnaus Jevonso paradoksas – t.y., technologiniam progresui mažinant kainas, atsiranda daug daugiau galimų pelningų dirbtinio intelekto pritaikymu, ir gale net ir smunkant kainoms apyvarta visvien eksponentiškai auga.
Taigi, Nvidia akcijos kaina atsigavo, visi nusiramino, euforija sugrįžo, ir vėl pradėjome eksponentišku tempu investuoti į dirbtinio intelekto infrastruktūrą – duomenų centrus, pilnus grafinių lustų. Be to, agentų paradigmas 2025-ųjų antroje pusėje staiga įgalino dirbtinį intelektą naudoti programavimui, ir visi tiesiog pametė galvas.
Kaip įrodymą, kad Jevonso paradoksas veikia, dirbtinio intelekto pranašai rodo visuotinį tokenų suvartojimą. Kiek iš tikrųjų jų suvartojama, niekas dorai nežino, bet galima stebėti OpenRouter įmonės skelbiamą statistiką. OpenRouter – tai tokia aitišnikų platforma, kuri leidžia sistemą lengvai prijungti prie bet kokio modelio, taip ieškant geriausio ir pigiausio. Ne visiems ir tikrai ne visada reikia mokėti 25 dolerius už milijoną Antropiko output tokenų. Štai AirBnB atsako į beveik pusę visų vartotojų užklausų naudodami kinų atvirus ir pigius modelius.
Štai kaip atrodo OpenRouter skelbiamas visuotinis tokenų vartojimas:
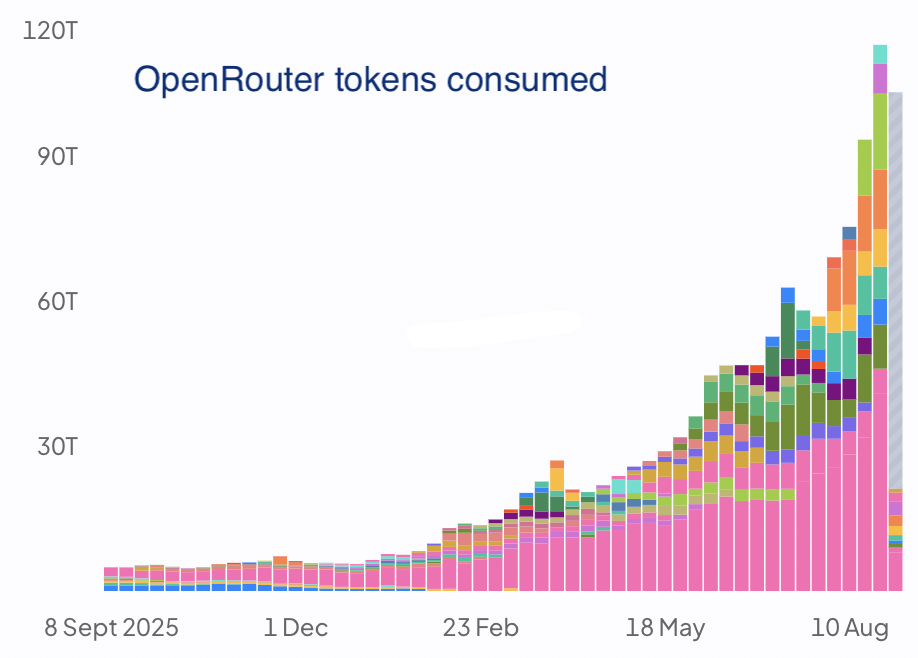
Eksponentinis augimas, per paskutinius porą mėnesių padvigubėjom, o per metus padarėm kart dvidešimt penki. Tiesiog neįtikėtina. Atrodo, išties niekada neužteks grafinių lustų, nes skaičiavimo paklausa – beribė.
Tik va, matuoti skaičiavimo poreikius tokenais nėra visiškai teisinga. Yra pavyzdžiui labai paprastų ir pigių modelių, su mažai parametrų, kuriems reikia labai mažai skaičiavimo pajėgumų. Teisingiau būtų skaičiuoti pinigais. Juk investuojant į naujų duomenų centrų statybas, svarbu tik, kiek surenkama pinigų už duomenų centrų paslaugas. O štai apie šitą kažkodėl niekas nekalba. Duomenų nėra.
Tiksliau, yra, bet niekas jų nežiūri. OpenRouter skelbia dieninę visų modelių vartojimo statistiką, prieinamą per API – kompiuterinę užklausą, aprašytą čia: https://openrouter.ai/docs/api/api-reference/datasets/daily-token-totals-for-top-50-models?playground=open. Užklausa atiduoda baisybę duomenų tokia forma:
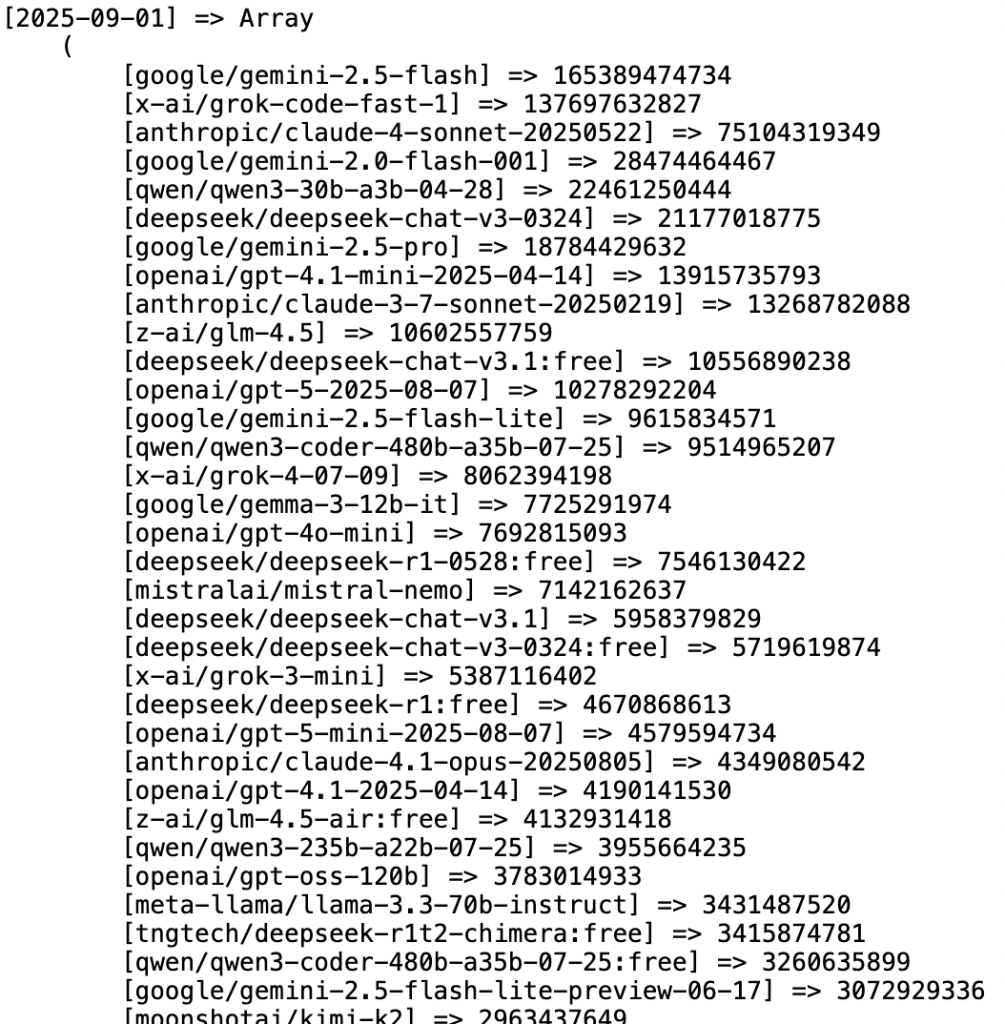
T.y., kiek tokenų kiekvieną dieną suvartojo kiekvienas modelis. Kainų neturime, bet kas nori, gali rasti. Aš norėjau:
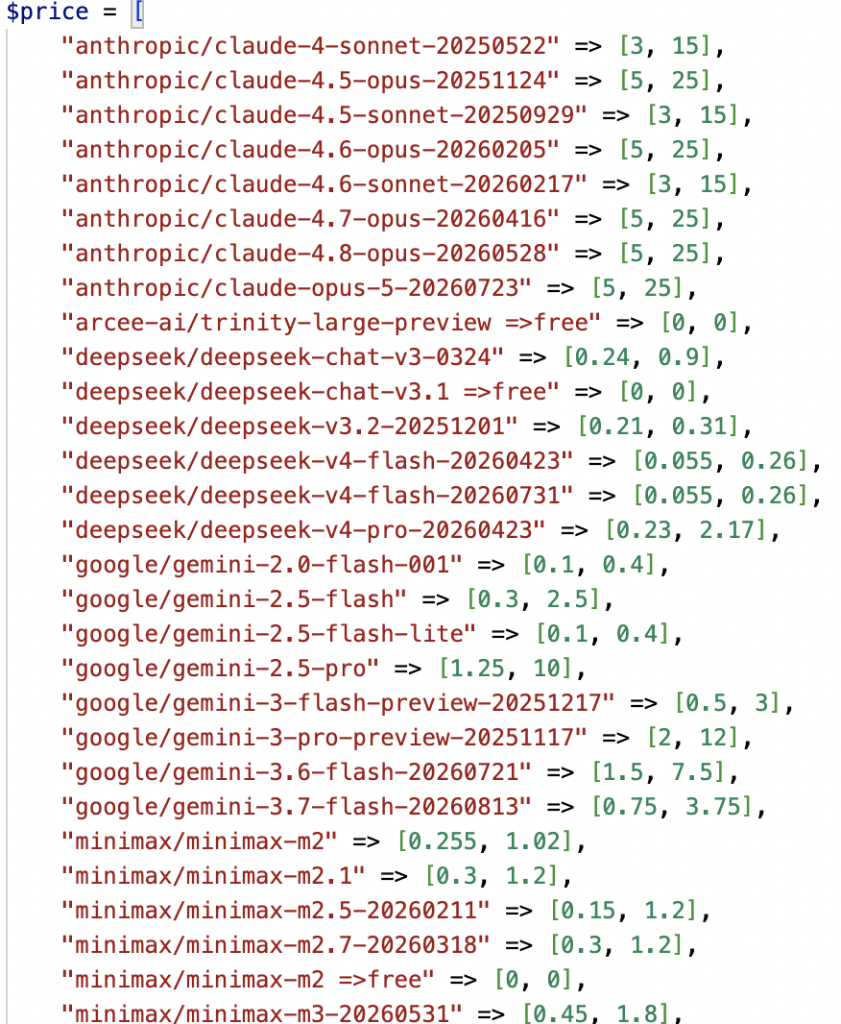
… ir dar daug eilučių. Pastebėsite, kiekvienas modelis turi dvi kainas – todėl kad “input” ir “output” tokenai skiriasi. Kainos doleriais, milijonui tokenų.
Tai va, turint kiekvienos dienos kiekvieno modelio sunaudotus tokenus, ir tokenų kainas, ir darant keletą prielaidų, kaip kad:
- modelio tokenų kainos laike nesikeičia
- suvartojamų input ir output tokenų santykis kažkur apie 3:1
Suskaičiuojame tokią statistiką apie vidutinę tokenų, suvartojamų OpenRouter platformoje, kainą, ir visus pinigus, išleidžiamus duomenų centruose ant skaičiavimų:
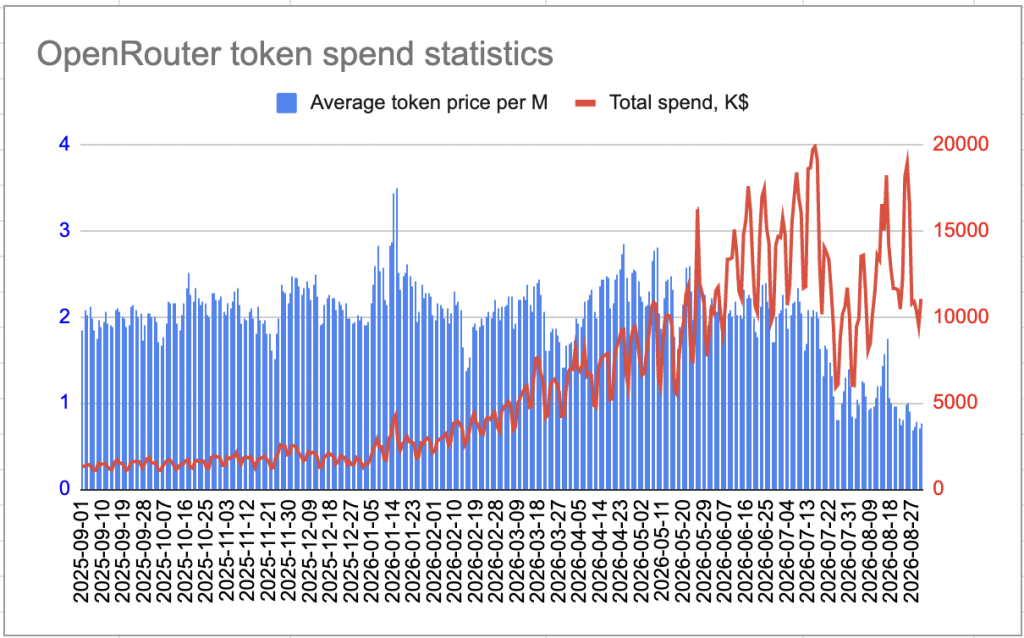
O šitas grafikas įstabiai skiriasi nuo pradinio, eksponentiškai augančio suvartotų tokenų skaičiaus grafiko. Jau porą mėnesių nustojo augti duomenų centrų pajamos. Jevonso paradoksas įstrigo – kainos krenta greičiau, nei auga vartojimas. Tai įmanoma tik tuo atveju, kai “frontier” modelius visiškai apdeda atviri modeliai – apdeda taip baisiai, kad net Lietuvos krepšinio rinktinė visai gerai atrodo po savo pralaimėjimo prieš turkus.
Gal todėl Antropikas taip skuba listinguoti savo akcijas rinkoje? Nes suvartojamų tokenų vidutinės kainos pradėjo kristi tik liepos mėnesį, t.y. jau pasibaigus antram ketvirčiui, ir finansinės šio reiškinio pasekmės dar nebus matomos listingavimo dokumentuose.
Gal todėl ir Nvidia rezultatai buvo tokia blogi? Primenu, išskaičiavus klientų neapmokėtų sąskaitų augimą, ketvirčio pajamos smuko 7%.
Bet kol kas apie tai niekas nekalba.
Leave a Reply